Embodied Spatial Reasoning Publications


* Equal contribution  ·  + Equal advising
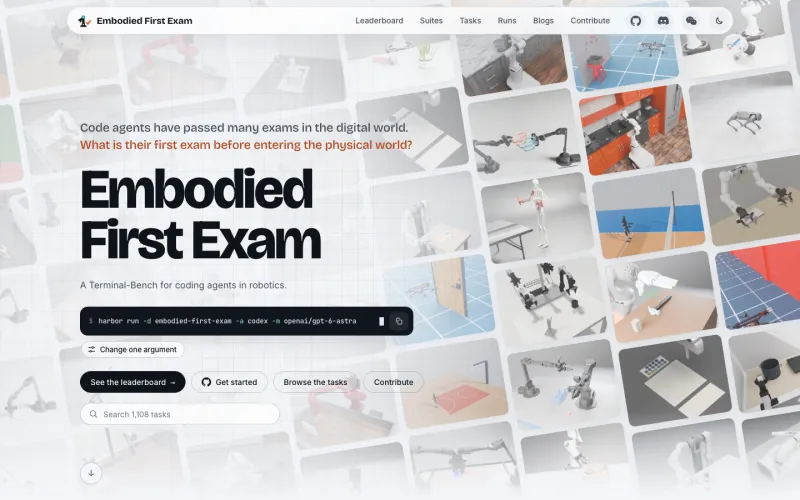
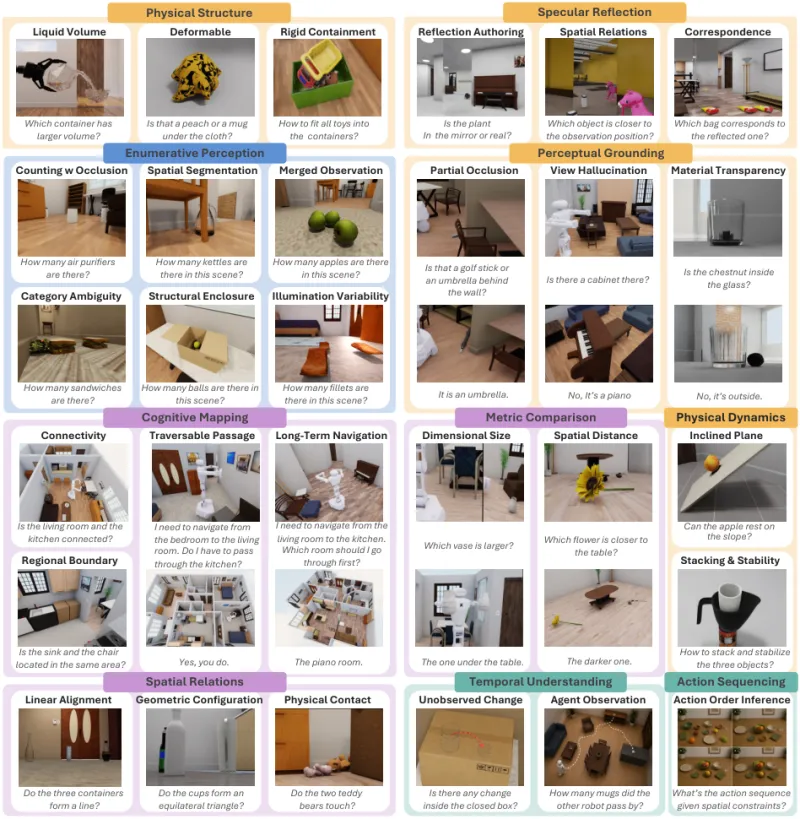
Embodied First Exam teaser

Embodied First Exam [Website][Code][Video]
Kangrui Wang*, Qineng Wang*, Changhe Chen*, Pingyue Zhang*, Chi Gui*, Feishi Wang, Canyu Chen, Wenli Xiao, Xiaoyu Huang, Tonghe Zhang, Linjie Li, Zihan Wang, Minyeong Kim, Yiyou Sun, Mingkai Deng, Jinyu Hou, Eric P. Xing, Han Liu, Qi Zhu, Huaxiu Yao, Zhiwen Fan, Yuejiang Liu, Dawn Song, Pieter Abbeel, Li Fei-Fei, Jiajun Wu, Yuke Zhu, Guanya Shi+, Ruohan Zhang+, Manling Li+
Code AgentsEmbodied AI BenchmarkRobot ManipulationHumanoid Robots

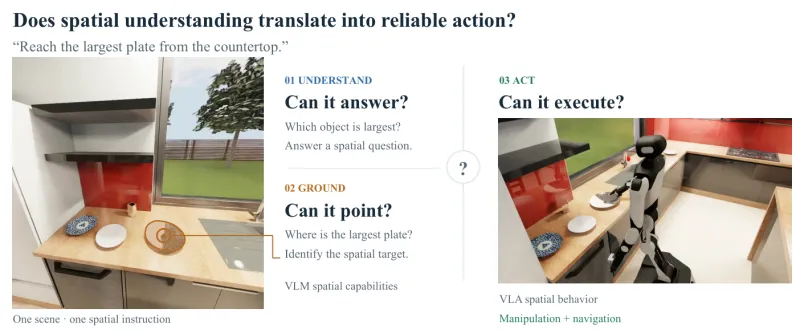
BEHAVIOR-Spatial Benchmark: Evaluating Spatial Understanding for Robotics teaser

BEHAVIOR-Spatial Benchmark: Evaluating Spatial Understanding for Robotics [Website][PDF]
Sirui Chen*, Huang Huang*, Qineng Wang, Wenlong Huang, Manling Li, Ruohan Zhang, Li Fei-Fei, Jiajun Wu

Spatial UnderstandingRobot ManipulationVision-Language-Action ModelsSpatial GroundingEmbodied Benchmark

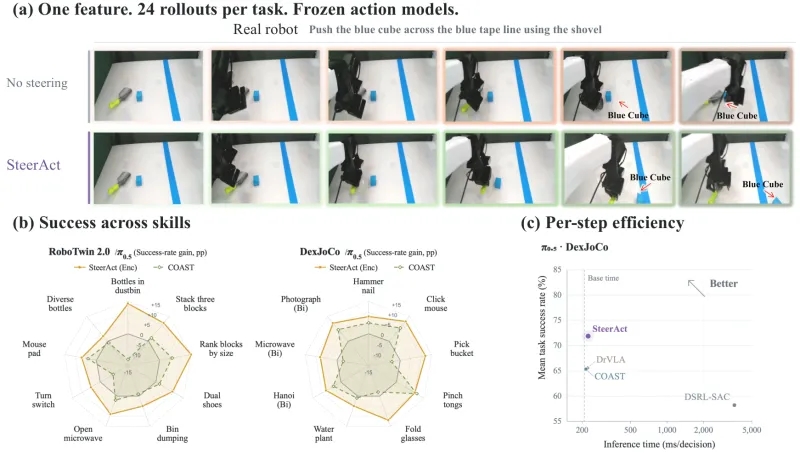
SteerAct: Unlocking Action Models through Few-Shot Temporal Steering teaser

SteerAct: Unlocking Action Models through Few-Shot Temporal Steering [Website][PDF]
Kaichen Zhou*, Zhiyan Li*, Chongkai Gao, Yuhan Wang, Wenlong Huang, Maggie Wang, Fangneng Zhan, Manling Li, Qianqian Wang, Mac Schwager, Zhuang Liu, Li Fei-Fei, Mengyu Wang+, Paul Pu Liang+

Activation SteeringRobot Action ModelsSparse AutoencodersTest-Time AdaptationRobot Manipulation

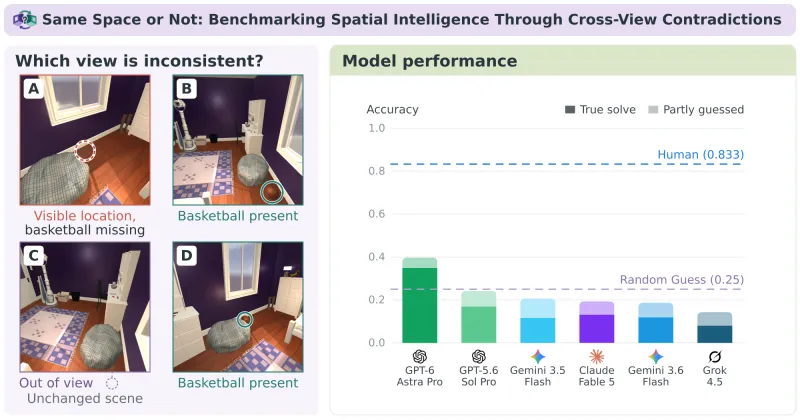
Same Space or Not: Benchmarking Spatial Intelligence Through Cross-View Contradictions teaser

Same Space or Not: Benchmarking Spatial Intelligence Through Cross-View Contradictions [Website][PDF][Code]
Huizi Cao, Guanyu Xu, Zhixuan Liang, Ming Yin, Jiuxiang Gu, Manling Li, Mengdi Wang, Shilong Liu

Spatial IntelligenceCross-View ConsistencyVision-Language ModelsMulti-View Reasoning3D Scene Understanding

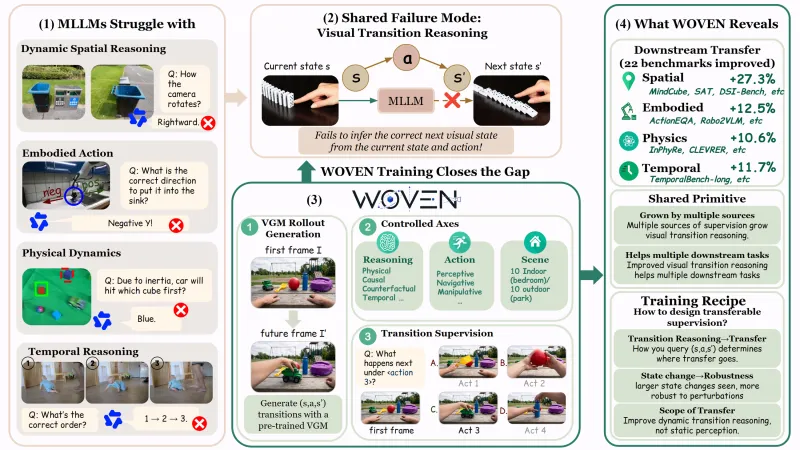
WOVEN: Weaving Visual World Modeling into Multimodal LLMs teaser

WOVEN: Weaving Visual World Modeling into Multimodal LLMs [Website][PDF][Code]
Zheyu Fan, Yue Zhang, Mingkai Deng, Kangrui Wang, Qineng Wang, Canyu Chen, Jie Hao, Xing Fan, Chenlei Guo, Eric P. Xing, Mohit Bansal, Manling Li

Visual World ModelingVisual Transition ReasoningMultimodal LLMsBenchmark and Training DataTraining Recipe

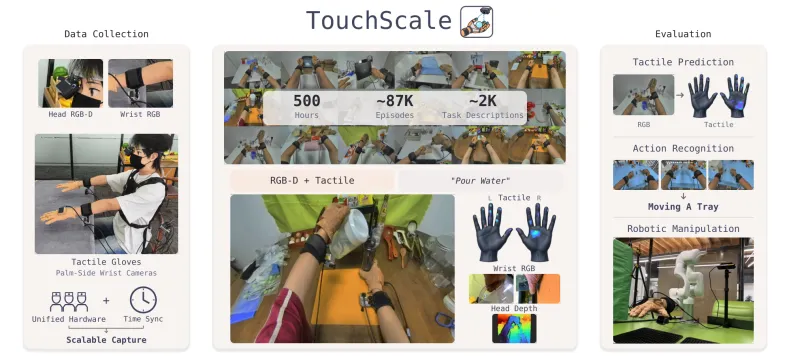
TouchScale: 500 Hours of Human Vision and Touch for Visual-Tactile Learning teaser

TouchScale: 500 Hours of Human Vision and Touch for Visual-Tactile Learning [Website][PDF]
Dayou Li*, Hao Wang*, Qianqian Yang*, Zihao Zhu*, Haoquan Fang, Ziyao Zeng, Yan Han, Zihan Wang, Yan Wang, Baoru Huang, Dilin Wang, Kenji Shimada, Yiyue Luo, Manling Li, Teresa Lv, Mustafa Mukadam, Rakesh Ranjan, Ruohan Zhang, Qi He, Changliu Liu, Xu Chen, Marco Pavone, Bangya Liu, Jiachen Li, Masayoshi Tomizuka, Zhiwen Fan
Visual-Tactile LearningEgocentric DatasetHuman Touch DataRobotic ManipulationData Scaling

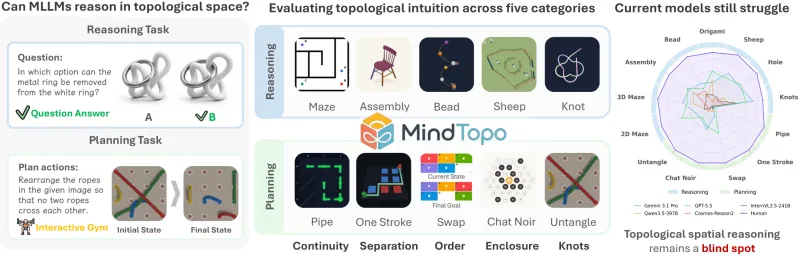
MindTopo: Can Foundation Models Reason in Topological Space? teaser

MindTopo: Can Foundation Models Reason in Topological Space? [Website][PDF][Code]
Yunfei Ge*, Anbang Liu*, Qineng Wang*, Johnalbert Garnica*, Jianwen Lyu, Zihan Wang, Reuben Tan, Jianfeng Gao, Ruohan Zhang, Yining Hong, Jiajun Wu, Manling Li

Topological ReasoningSpatial IntelligenceMLLM BenchmarkEmbodied PlanningVideo Generation Models

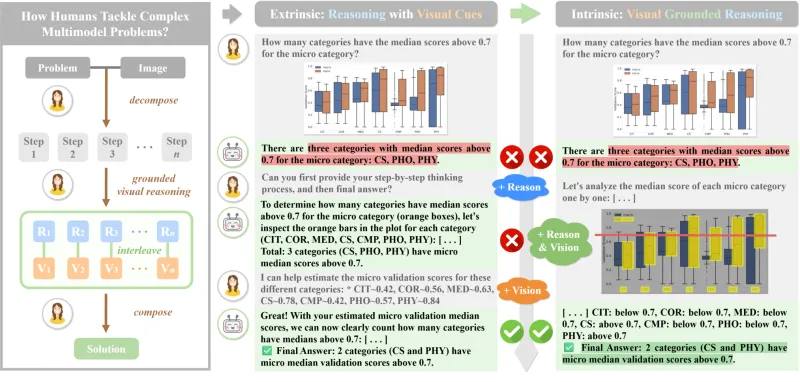
CURV: Enhancing Chart Understanding Through Curriculum Visual Grounded Reasoning teaser

CURV: Enhancing Chart Understanding Through Curriculum Visual Grounded Reasoning [Website][PDF]
Xuehang Guo, Pingyue Zhang, Ruiyi Zhang, Zhenhailong Wang, Hanrui Lyu, Heng Ji, Tong Sun, Qingyun Wang, Manling Li

Chart Question AnsweringVisual Grounded ReasoningCurriculum LearningMultimodal LLMsSynthetic Data Generation

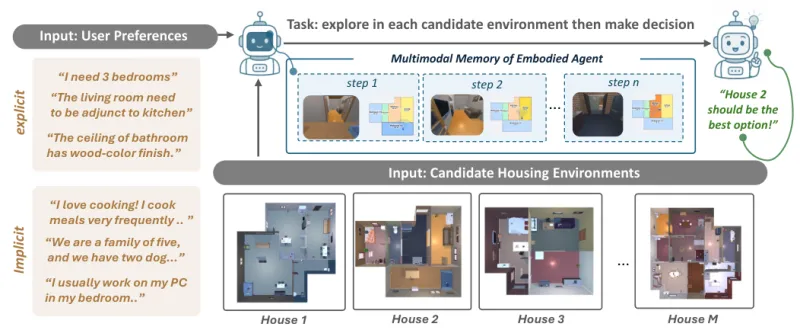
Long-Horizon Embodied Decision-Making via Multimodal Memory Compression teaser

Long-Horizon Embodied Decision-Making via Multimodal Memory Compression [PDF]
Bingxuan Li, Rui Yang, Cheng Qian, Jiateng Liu, Jeonghwan Kim, Zhenhailong Wang, Manling Li, Tong Zhang, Heng Ji
Embodied Decision-MakingLong-Horizon MemoryMultimodal Memory CompressionPreference AlignmentEmbodied Benchmark

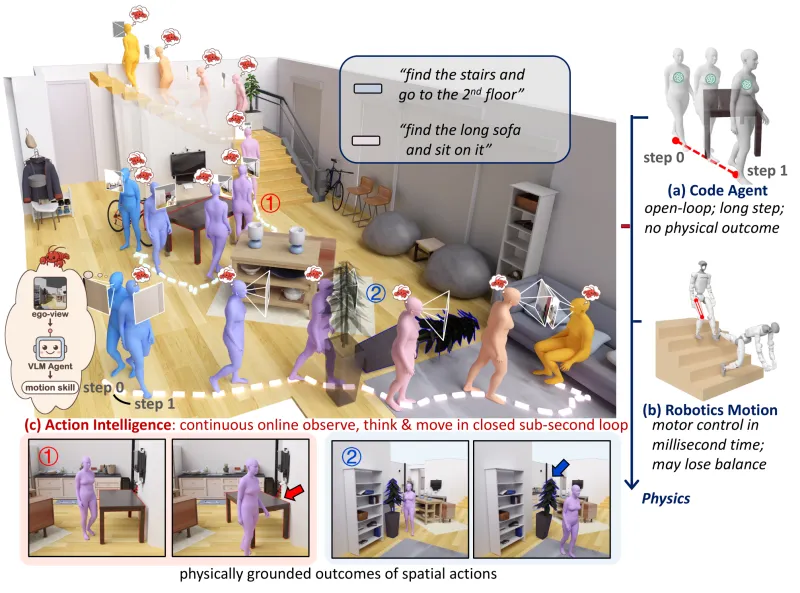
HumanCLAW: Can Vision-Language Models Act Through a Body? teaser

HumanCLAW: Can Vision-Language Models Act Through a Body? [Website][PDF]
Li Siyao*, Jiawei Gu*, Shuai Liu*, Kairui Hu*, Zekun Li, Linjie Li, Chengcheng Tang, Po-Chen Wu, Ivan Shugurov, Lingni Ma, Michael Zollhoefer, Sizhe An, Abhay Mittal+, Amy Zhao+, Ranjay Krishna+, Manling Li+, Ziwei Liu+, Chuan Guo+
Embodied VLM EvaluationHumanoid Action IntelligenceEmbodied Self-AwarenessEgocentric NavigationFull-Body Motion

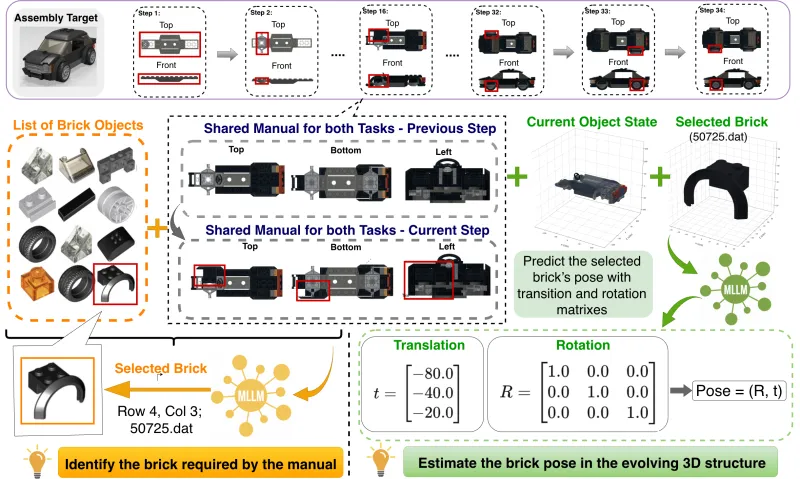
Brick-Composer: Using MLLMs for Assembly with Diverse Bricks teaser

Brick-Composer: Using MLLMs for Assembly with Diverse Bricks [PDF][Code]
Jiateng Liu, Bingxuan Li, Zhenhailong Wang, Rushi Wang, Kaiwen Hong, Cheng Qian, Jiayu Liu, Denghui Zhang, Katherine Driggs-Campbell, Manling Li, Heng Ji

Brick AssemblyMultimodal LLMsPose EstimationSpatial ReasoningBenchmark

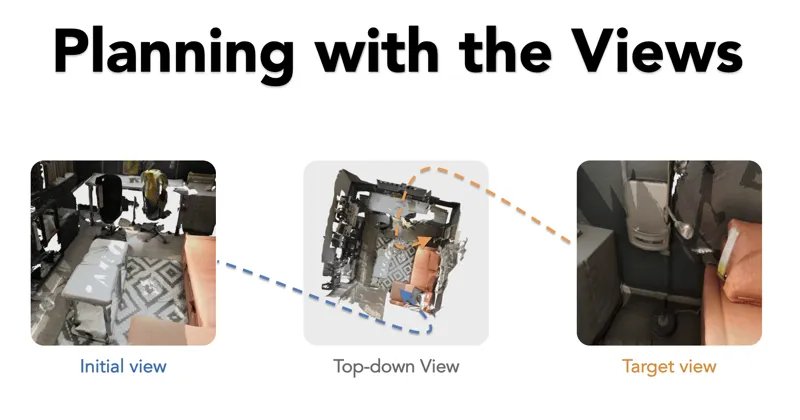
Planning with the Views teaser

Planning with the Views [Website][PDF][Code][Data][Models][tl;dr]
Kangrui Wang, Linjie Li, Zhengyuan Yang, Shiqi Chen, Zihan Wang, Li Fei-Fei, Jiajun Wu, Leonidas Guibas, Lijuan Wang, Manling Li

View PlanningSpatial ReasoningActive PerceptionEmbodied Agents

ESI-Bench: Towards Embodied Spatial Intelligence that Closes the Perception-Action Loop teaser

ESI-Bench: Towards Embodied Spatial Intelligence that Closes the Perception-Action Loop [Website][PDF]
Yining Hong*, Jiageng Liu*, Han Yin, Manling Li, Leonidas Guibas, Li Fei-Fei, Jiajun Wu, Yejin Choi

Embodied Spatial IntelligenceActive PerceptionBenchmarkMultimodal LLMsOmniGibson

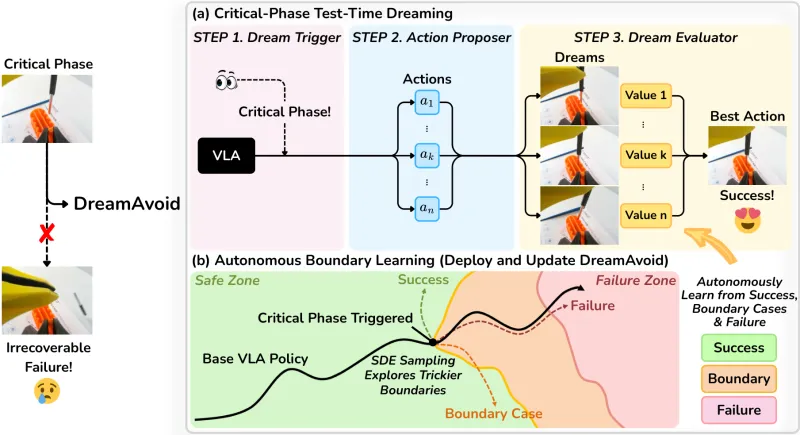
DreamAvoid: Critical-Phase Test-Time Dreaming to Avoid Failures in VLA Policies teaser

DreamAvoid: Critical-Phase Test-Time Dreaming to Avoid Failures in VLA Policies [PDF][Code]
Xianzhe Fan, Yuxiang Lu, Shenyuan Gao, Xiaoyang Wu, Ruihua Han, Manling Li, Hengshuang Zhao

Vision-Language-Action ModelsTest-Time DreamingFailure AvoidanceWorld Model EvaluationRobot Manipulation

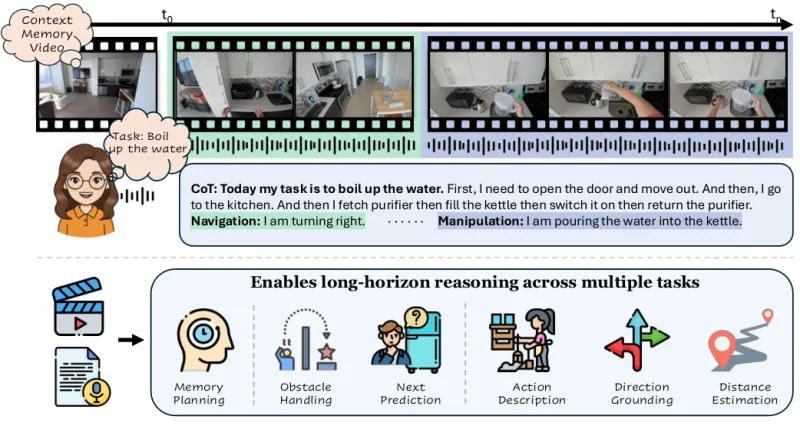
EgoTL: Egocentric Think-Aloud Chains for Long-Horizon Tasks teaser

EgoTL: Egocentric Think-Aloud Chains for Long-Horizon Tasks [Website][PDF]
Lulin Liu*, Dayou Li*, Yiqing Liang, Sicong Jiang, Hitesh Vijay, Hezhen Hu, Xuhai Xu, Zirui Liu, Srinivas Shakkottai, Manling Li, Zhiwen Fan

Egocentric VideoThink-Aloud Chain-of-ThoughtLong-Horizon PlanningSpatial GroundingWorld Model Benchmark

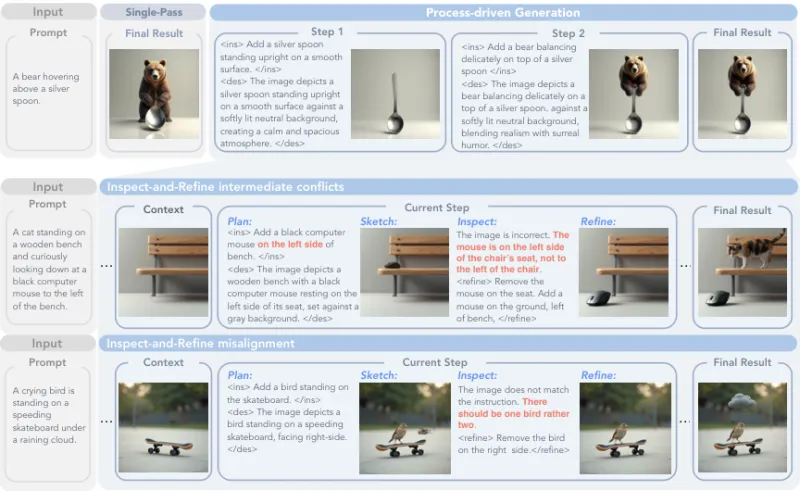
Think in Strokes, Not Pixels: Process-Driven Image Generation via Interleaved Reasoning teaser

Think in Strokes, Not Pixels: Process-Driven Image Generation via Interleaved Reasoning [PDF]
Lei Zhang, Junjiao Tian, Zhipeng Fan, Kunpeng Li, Jialiang Wang, Weifeng Chen, Markos Georgopoulos, Felix Juefei-Xu, Yuxiang Bao, Julian McAuley+, Manling Li+, Zecheng He+
Process-Driven Image GenerationInterleaved Text-Image ReasoningUnified Multimodal ModelsStep-Wise SupervisionVisual Self-Reflection

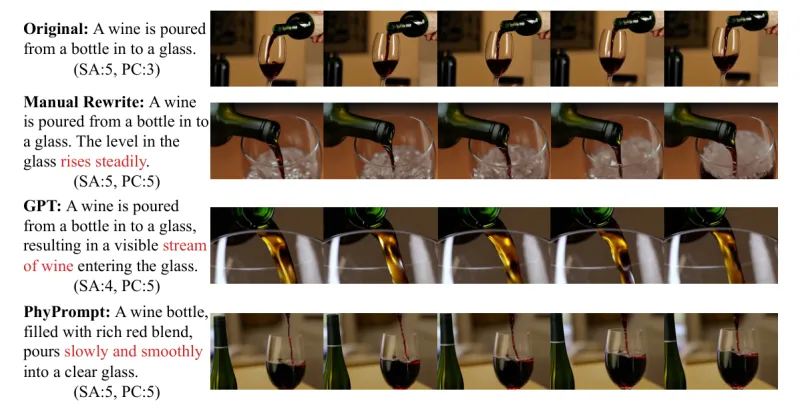
PhyPrompt: RL-based Prompt Refinement for Physically Plausible Text-to-Video Generation teaser

PhyPrompt: RL-based Prompt Refinement for Physically Plausible Text-to-Video Generation [PDF]
Shang Wu, Chenwei Xu, Zhuofan Xia, Weijian Li, Lie Lu, Pranav Maneriker, Fan Du, Manling Li, Han Liu
Physically Plausible Video GenerationPrompt RefinementReinforcement LearningReward CurriculumPhysical CommonsenseText-to-Video Generation

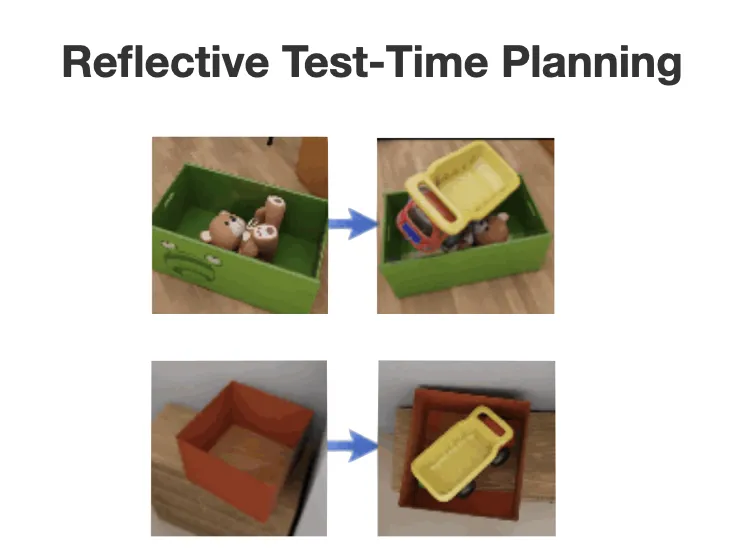
Learning from Trials and Errors: Reflective Test-Time Planning for Embodied LLMs teaser

Learning from Trials and Errors: Reflective Test-Time Planning for Embodied LLMs [Website][PDF][Code][tl;dr]
Yining Hong, Huang Huang, Manling Li, Li Fei-Fei, Leonidas Guibas, Jiajun Wu, Yejin Choi
NeurIPS 2026
Best Paper Award at CVPR 2026 Workshop on Test-Time Scaling for Computer Vision (ViSCALE)
Test-Time PlanningSelf-ReflectionLearning from FailureEmbodied Planning

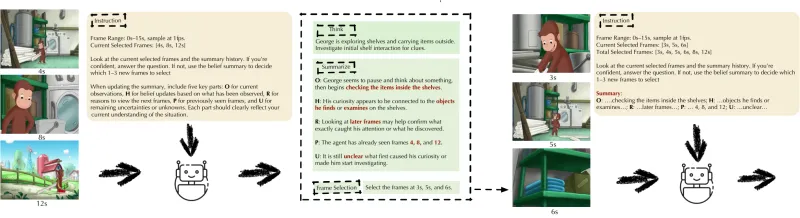
Towards Sparse Video Understanding and Reasoning teaser

Towards Sparse Video Understanding and Reasoning [Website][PDF]
Chenwei Xu, Zhen Ye, Shang Wu, Weijian Li, Zihan Wang, Zhuofan Xia, Lie Lu, Pranav Maneriker, Fan Du, Manling Li, Han Liu
CVPR 2026

Sparse Video ReasoningVideo Question AnsweringMulti-Round Video AgentReinforcement LearningAnnotation-Free RewardFrame Selection

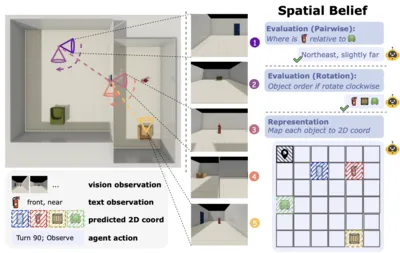
Theory of Space: Can Foundation Models Construct Spatial Beliefs through Active Exploration? teaser

Theory of Space: Can Foundation Models Construct Spatial Beliefs through Active Exploration? [Website][PDF][Data][Code]
Pingyue Zhang*, Zihan Huang*, Yue Wang *, Jieyu Zhang*, Letian Xue, Zihan Wang, Qineng Wang, Keshigeyan Chandrasegaran, Yejin Choi, Ranjay Krishna, Ruohan Zhang, Jiajun Wu, Li Fei-Fei, Manling Li
ICLR 2026
Featured by MIT Tech Review China, Stanford AI Blog
Spatial IntelligenceActive PerceptionActive ExplorationSpatial BeliefsWorld ModelsFoundation Models

CaptionQA: Is Your Caption as Useful as the Image Itself? teaser

CaptionQA: Is Your Caption as Useful as the Image Itself? [Website][PDF][Code]
Shijia Yang*, Yunong Liu*, Bohan Zhai*, Ximeng Sun, Zicheng Liu, Emad Barsoum, Manling Li, Chenfeng Xu

Caption EvaluationMultimodal BenchmarkCaption UtilityVision-Language ModelsEmbodied AI

ENACT: Evaluating Embodied Cognition with World Modeling of Egocentric Interaction teaser

ENACT: Evaluating Embodied Cognition with World Modeling of Egocentric Interaction [Website][PDF][Code][Data][tl;dr]
Qineng Wang*, Wenlong Huang*, Yu Zhou, Hang Yin, Tianwei Bao, Jianwen Lyu, Weiyu Liu, Ruohan Zhang, Jiajun Wu, Li Fei-Fei, Manling Li
ICLR 2026
Outstanding Paper Award at ICLR 2026 Workshop on World Models
Outstanding Paper Award at ICLR 2026 Workshop on Lifelong Agents
Embodied CognitionWorld ModelingEgocentric InteractionEmbodied AI Benchmark

MindCube: Spatial Mental Modeling from Limited Views teaser

MindCube: Spatial Mental Modeling from Limited Views [Website][PDF][Data][Code][tl;dr]
Qineng Wang*, Baiqiao Yin*, Pingyue Zhang, Jianshu Zhang, Kangrui Wang, Zihan Wang, Jieyu Zhang, Keshigeyan Chandrasegaran, Han Liu, Ranjay Krishna, Saining Xie, Jiajun Wu+, Li Fei-Fei+, Manling Li+
ICLR 2026
Best Paper Award at ICCV 2025 Workshop on Structural Priors for Vision
Best Paper Honorable Mention at NeurIPS 2025 Workshop on Language Agents and World Models (LAW)
The Best of ICCV 2025, featured by Voxel 51
Spatial ReasoningSpatial Mental ModelsCognitive MapsVision-Language ModelsSpatial Intelligence

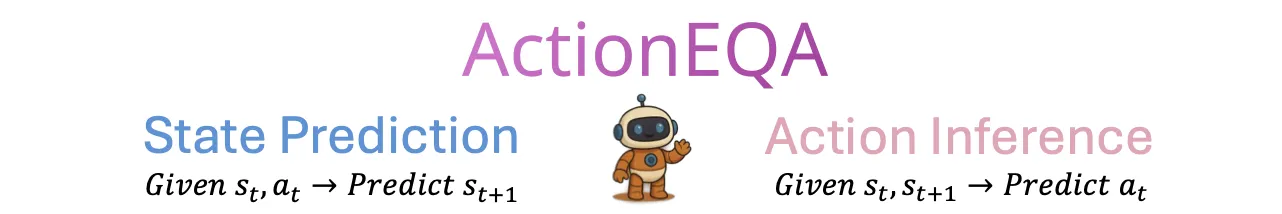
ActionEQA: Action Interface for Embodied Question Answering teaser

ActionEQA: Action Interface for Embodied Question Answering [PDF]
Tianwei Bao, Qineng Wang, Kangrui Wang, Mingkai Deng, Guangyi Liu, Jiayuan Mao, Lawrence Birnbaum, Zhiting Hu, Eric P. Xing, Zhaoran Wang, Manling Li
TMLR 2026
Embodied Question AnsweringAction InterfaceEmbodied AgentsSpatial Reasoning

Exploring Diffusion Transformer Designs via Grafting teaser

Exploring Diffusion Transformer Designs via Grafting [Website][PDF][Blog][Code][tl;dr]
Keshigeyan Chandrasegaran*, Michael Poli*, Daniel Y. Fu, Dongjun Kim, Lea M. Hadzic, Manling Li, Agrim Gupta, Stefano Massaroli, Azalia Mirhoseini, Juan Carlos Niebles, Stefano Ermon, Li Fei-Fei
NeurIPS 2025 (Oral, Top 0.36%)
Diffusion TransformersModel GraftingArchitecture DesignGenerative Models

EmbodiedBench: Comprehensive Benchmarking Multi-modal Large Language Models for Vision-Driven Embodied Agents teaser

EmbodiedBench: Comprehensive Benchmarking Multi-modal Large Language Models for Vision-Driven Embodied Agents [Website][PDF][Code][tl;dr]
Rui Yang, Hanyang Chen, Junyu Zhang, Mark Zhao, Cheng Qian, Kangrui Wang, Qineng Wang, Teja Venkat Koripella, Marziyeh Movahedi, Manling Li, Heng Ji, Huan Zhang, Tong Zhang
ICML 2025 (Oral, Top 1%)
Embodied AgentsMultimodal LLMsEmbodied AI BenchmarkVision-Driven Agents

Why Is Spatial Reasoning Hard for VLMs? An Attention Mechanism Perspective on Focus Areas teaser

Why Is Spatial Reasoning Hard for VLMs? An Attention Mechanism Perspective on Focus Areas [PDF][Code][Data]
Shiqi Chen, Tongyao Zhu, Ruochen Zhou, Jinghan Zhang, Siyang Gao, Juan Carlos Niebles, Mor Geva, Junxian He, Jiajun Wu, Manling Li
ICML 2025

Spatial ReasoningAttention MechanismsVLM InterpretabilityAdaptive Decoding

Bring Reason to Vision: Understanding Perception and Reasoning through Model Merging teaser

Bring Reason to Vision: Understanding Perception and Reasoning through Model Merging [PDF][Code]
Shiqi Chen, Jinghan Zhang, Tongyao Zhu, Wei Liu, Siyang Gao, Miao Xiong, Manling Li, Junxian He
ICML 2025

Model MergingPerception and ReasoningVision-Language Models

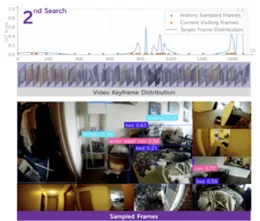
T*: Re-thinking Temporal Search for Long-Form Video Understanding teaser

T*: Re-thinking Temporal Search for Long-Form Video Understanding [Website][PDF][Data][Code]
Jinhui Ye*, Zihan Wang*, Haosen Sun, Keshigeyan Chandrasegaran, Zane Durante, Cristobal Eyzaguirre, Yonatan Bisk, Juan Carlos Niebles, Ehsan Adeli, Li Fei-Fei, Jiajun Wu, Manling Li
CVPR 2025, Oral at ICCV 2025 Workshop on Long Multi-Scene Video Foundations
Long-Form Video UnderstandingTemporal SearchVideo-Language ModelsKeyframe Selection

LayoutVLM: Differentiable Optimization of 3D Layout via Vision-Language Models teaser

LayoutVLM: Differentiable Optimization of 3D Layout via Vision-Language Models [Website][PDF][Code]
Fan-Yun Sun, Weiyu Liu, Siyi Gu, Dylan Lim, Goutam Bhat, Federico Tombari, Manling Li, Nick Haber, Jiajun Wu
CVPR 2025

3D Scene LayoutSpatial ReasoningDifferentiable OptimizationVision-Language Models

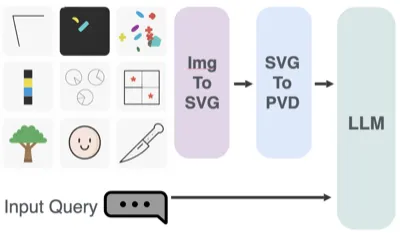
Visually Descriptive Language Model for Vector Graphics Reasoning teaser

Visually Descriptive Language Model for Vector Graphics Reasoning [PDF][Website][Code]
Zhenhailong Wang, Joy Hsu, Xingyao Wang, Kuan-Hao Huang, Manling Li, Jiajun Wu, Heng Ji
TMLR

Vector Graphics ReasoningVisual ReasoningSymbolic Representations

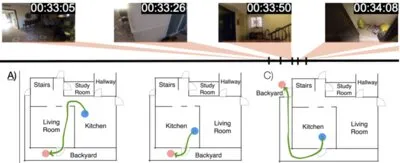
HourVideo: 1-Hour Video-Language Understanding teaser

HourVideo: 1-Hour Video-Language Understanding [Website][PDF][Data][Code]
Keshigeyan Chandrasegaran, Agrim Gupta, Taran Kota, Lea M. Hadzic, Jimming He, Cristobal Eyzaguirre, Zane Durante, Manling Li, Jiajun Wu, Li Fei-Fei
NeurIPS 2024 Datasets and Benchmarks Track

Long-Form Video UnderstandingVideo-Language BenchmarkEgocentric Video

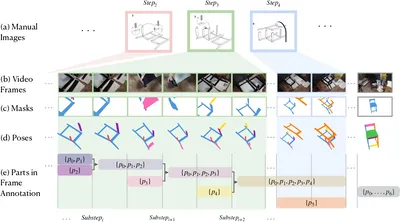
IKEA Manuals at Work: 4D Grounding of Assembly Instructions on Internet Videos teaser

IKEA Manuals at Work: 4D Grounding of Assembly Instructions on Internet Videos [Website][PDF][Data][Code]
Yunong Liu, Weiyu Liu, Shubh Khanna, Cristobal Eyzaguirre, Manling Li, Juan Carlos Niebles, Vineeth Ravi, Saumitra Mishra, Jiajun Wu
NeurIPS 2024 Datasets and Benchmarks Track

4D GroundingAssembly InstructionsProcedural Video Understanding

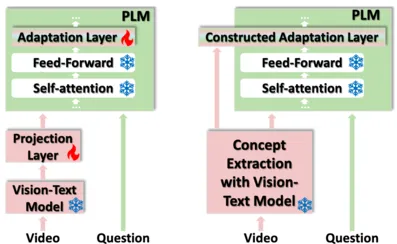
Deep Concept Injection for Zero-shot Multimodal Reasoning teaser

Deep Concept Injection for Zero-shot Multimodal Reasoning [PDF]
Xudong Lin, Manling Li, Richard Zemel, Heng Ji, Shih-Fu Chang
EMNLP 2024
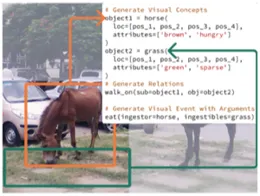
Zero-Shot Multimodal ReasoningConcept InjectionVideo Question Answering

ViStruct: Visual Structural Knowledge Extraction via Curriculum Guided Code-Vision Representation teaser

ViStruct: Visual Structural Knowledge Extraction via Curriculum Guided Code-Vision Representation [PDF]
Yangyi Chen, Xingyao Wang, Manling Li, Derek Hoiem, Heng Ji
EMNLP 2023
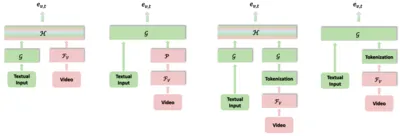
Visual Knowledge ExtractionCurriculum LearningCode-Vision Representation

Towards Fast Adaptation of Pretrained Contrastive Models for Multi-channel Video-Language Retrieval teaser

Towards Fast Adaptation of Pretrained Contrastive Models for Multi-channel Video-Language Retrieval [PDF][Code]
Xudong Lin, Simran Tiwari, Shiyuan Huang, Manling Li, Mike Zheng Shou, Heng Ji, Shih-Fu Chang
CVPR 2023

Video-Language RetrievalContrastive LearningEfficient Adaptation

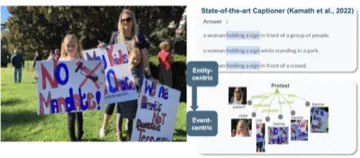
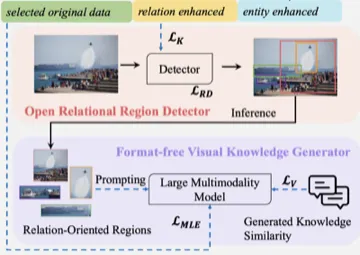
Open Visual Knowledge Extraction via Relation-Oriented Multimodality Model Prompting teaser

Open Visual Knowledge Extraction via Relation-Oriented Multimodality Model Prompting [PDF]
Hejie Cui, Xinyu Fang, Zihan Zhang, Ran Xu, Xuan Kan, Xin Liu, Manling Li, Yangqiu Song, Carl Yang
NeurIPS 2023
Visual Knowledge ExtractionMultimodal PromptingRelation Extraction

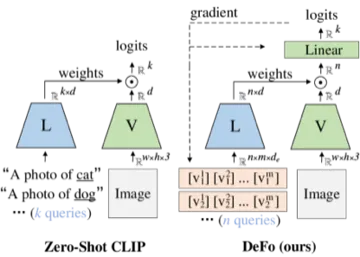
Learning to Decompose Visual Features with Latent Textual Prompts teaser

Learning to Decompose Visual Features with Latent Textual Prompts [PDF][Code]
Feng Wang†, Manling Li, Xudong Lin, Hairong Lv, Alexander Schwing, Heng Ji
ICLR 2023 († denotes supervised undergraduate)

Visual Feature DecompositionPrompt LearningCLIP

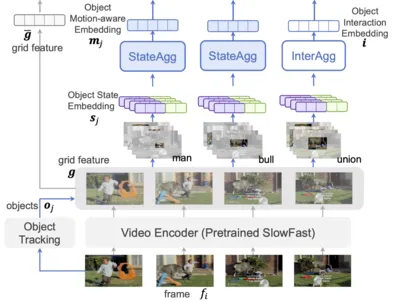
Video Event Extraction via Tracking Visual States of Arguments teaser

Video Event Extraction via Tracking Visual States of Arguments [PDF][Code]
Guang Yang†, Manling Li, Jiajie Zhang, Xudong Lin, Shih-Fu Chang, Heng Ji
AAAI 2023 († denotes supervised undergraduate)

Video Event ExtractionVisual State TrackingMultimodal Information Extraction

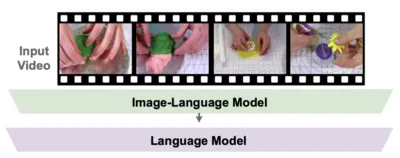
Language Models with Image Descriptors are Strong Few-Shot Video-Language Learners teaser

Language Models with Image Descriptors are Strong Few-Shot Video-Language Learners [PDF][Code]
Zhenhailong Wang†*,Manling Li*, Ruochen Xu, Luowei Zhou, Jie Lei, Xudong Lin, Shuohang Wang, Ziyi Yang, Chenguang Zhu, Derek Hoiem, Shih-Fu Chang, Mohit Bansal, Heng Ji
NeurIPS'22 (equal contribution)

Few-Shot Video-Language LearningImage DescriptorsLLM Prompting

CLIP-Event: Connecting Text and Images with Event Structures teaser

CLIP-Event: Connecting Text and Images with Event Structures [PDF][Data][Code]
Manling Li, Ruochen Xu, Shuohang Wang, Xudong Lin, Chenguang Zhu, Xuedong Huang, Heng Ji, Shih-Fu Chang
CVPR'22 (Oral, Top 4.1%)

Event StructuresVision-Language PretrainingZero-Shot TransferContrastive Learning

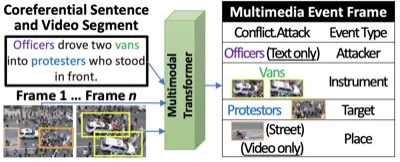
Joint Multimedia Event Extraction from Video and Article teaser

Joint Multimedia Event Extraction from Video and Article [PDF][Data]
Brian Chen, Xudong Lin, Christopher Thomas, Manling Li, Shoya Yoshida, Lovish Chum, Heng Ji and Shih-Fu Chang
EMNLP'21 Findings

Multimedia Event ExtractionVideo-Text UnderstandingInformation Extraction

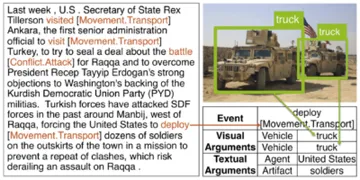
Cross-media Structured Common Space for Multimedia Event Extraction teaser

Cross-media Structured Common Space for Multimedia Event Extraction [PDF][Code][Slides]
Manling Li*, Alireza Zareian*, Qi Zeng, Spencer Whitehead, Di Lu, Heng Ji, Shih-Fu Chang
ACL'20: Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics, pp.2557–2568

Multimedia Event ExtractionCross-Media Common SpaceWeakly Supervised Learning